Le déploiement est terminé. L’API répond toujours avec succès, mais les requêtes prennent davantage de temps. L’application tourne sur ECS Fargate et dépend de PostgreSQL sur RDS. La nouvelle release attend-elle la base, sature-t-elle son pool de connexions, ou passe-t-elle plus de temps dans son propre code ?
CloudWatch Omni peut aider à réunir les preuves. Il ne peut ni remplacer une instrumentation absente, ni transformer une explication plausible en cause démontrée. L’expérience utile consiste à introduire une régression connue en staging, lancer une investigation et vérifier sa conclusion indépendamment.
Ce qu’AWS documente aujourd’hui
AWS a annoncé la disponibilité générale de CloudWatch Omni le 23 septembre 2026, en Virginie du Nord, Oregon et Irlande. Cette expérience d’observabilité des applications et agents IA repose sur CloudWatch et OpenTelemetry. L’architecture de staging ci-dessous choisit eu-west-1. Annonce de disponibilité AWS.
Omni distingue un domaine d’identité, un espace de travail et un CloudWatch Dataset. Un espace appartient à un compte et une région. Il découvre services et dépendances, permet de requêter la télémétrie et fournit un assistant capable de produire du SQL ou du PromQL. Une visibilité entre comptes ou régions nécessite des règles de centralisation CloudWatch ; Omni n’agrège pas ces sources seul. Concepts CloudWatch Omni.
| Statut | Ce que l’on peut affirmer |
|---|---|
| Capacité documentée | Requêter logs, traces et métriques ; examiner la santé des services et les dépendances observées. |
| Architecture proposée | Un compte de staging en Irlande, une API Fargate, un sidecar CloudWatch agent et PostgreSQL RDS privé. |
| Hypothèse à tester | La nouvelle révision de tâche passe davantage de temps dans un appel PostgreSQL. |
| Preuves encore nécessaires | Métadonnées de release corrélées, span SQL plus lent, attente côté base et récupération après rollback. |
L’assistant utilise les droits de télémétrie de la personne qui l’interroge. AWS précise que sa réponse peut être incorrecte et rend ses requêtes et preuves consultables. Ses conclusions restent des pistes à vérifier. Interroger l’agent Omni.
Une architecture de staging réalisable
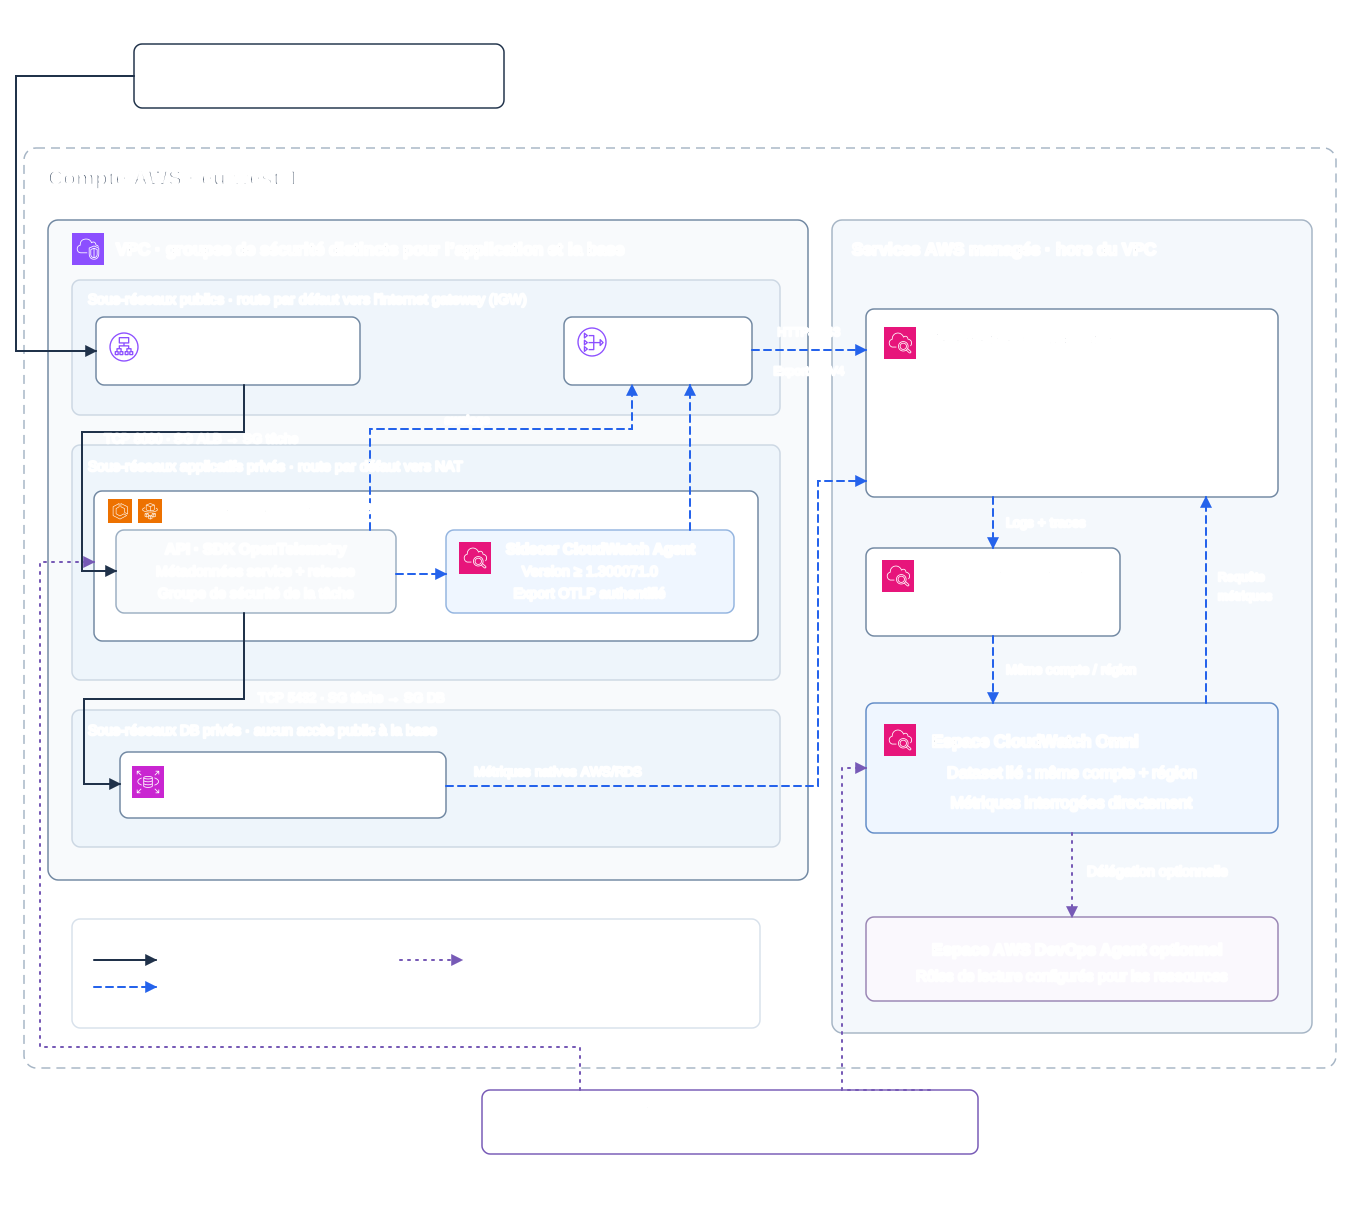
Le schéma distingue requêtes applicatives, exports de télémétrie et actions humaines. Il décrit une proposition, pas un environnement déjà en fonctionnement.
Prévoir un VPC sur deux zones de disponibilité. Un ALB distribue les requêtes au port 8080 de l’API. Les tâches Fargate résident dans des sous-réseaux applicatifs privés ; PostgreSQL réside dans des sous-réseaux de base privés, sans accès public. Autoriser le port 8080 depuis le groupe de sécurité de l’ALB vers celui des tâches, et TCP 5432 depuis celui des tâches vers celui de la base. Exiger TLS PostgreSQL avec vérification du certificat. Stocker les identifiants dans Secrets Manager et les injecter dans le conteneur applicatif.
Le schéma représente un ALB public HTTPS : cela demande un véritable certificat ACM et une configuration DNS, avec entrée restreinte au générateur. Une variante de lab peut utiliser un ALB HTTP interne et un générateur ayant accès au VPC ; adapter le schéma modifiable à ce listener et à cette frontière. Une seule NAT gateway simplifie le lab mais crée une dépendance à une zone et éventuellement du trafic inter-zone ; ce n’est pas une recommandation de haute disponibilité pour la production.
Les tâches privées utilisent la NAT pour joindre les endpoints de télémétrie et les dépendances d’images en HTTPS. C’est le chemin retenu ici ; une variante avec endpoints VPC demande de vérifier chaque dépendance, dont ECR, S3, logs et Secrets Manager. Aucun port OTLP entrant ne doit être exposé dans le groupe de sécurité des tâches. Le réseau awsvpc de Fargate fournit un espace réseau commun à l’application et au sidecar de la même tâche. Réseau Fargate.
RDS n’exécute pas le collecteur applicatif. Ses métriques natives proviennent d’AWS ; le span client SQL provient de l’API instrumentée. Les logs PostgreSQL demandent une configuration d’export RDS distincte. Enhanced Monitoring et Database Insights sont des choix supplémentaires, pas des effets de l’installation du sidecar. Outils de supervision RDS.
Instrumenter, collecter et authentifier l’export
Utiliser une instrumentation OpenTelemetry compatible avec le framework HTTP et le client PostgreSQL. La charger avant que l’application importe ces bibliothèques. Tracer la requête serveur entrante et l’opération SQL sortante. Propager le contexte entre appels applicatifs et corréler les logs avec trace_id et span_id lorsqu’un span actif existe.
Pour Fargate, AWS documente un sidecar CloudWatch agent, version 1.300071.0 ou ultérieure. Attacher CloudWatchAgentServerPolicy au task role. Faire dépendre l’application de l’agent avec la condition START : l’image AWS n’a pas de health check, donc HEALTHY bloquerait le démarrage. Figer le digest de l’image d’agent choisie pour l’expérience. Envoyer la télémétrie applicative.
Pour une API Python, le conteneur applicatif peut utiliser :
OTEL_SERVICE_NAME=staging-api
OTEL_RESOURCE_ATTRIBUTES=service.namespace=kloud-lab,service.version=release-a,deployment.environment.name=staging
OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4318
OTEL_EXPORTER_OTLP_PROTOCOL=http/protobuf
OTEL_TRACES_EXPORTER=otlp
OTEL_METRICS_EXPORTER=otlp
OTEL_LOGS_EXPORTER=otlp
OTEL_PYTHON_LOGGING_AUTO_INSTRUMENTATION_ENABLED=true
OTEL_TRACES_SAMPLER=always_on
Ces variables appartiennent à l’application. La configuration minimale de réception de l’agent est {"opentelemetry":{"collect":{"otlp":{}}}}. Le trafic local rejoint le sidecar ; celui-ci exporte ensuite en HTTPS avec SigV4, grâce aux identifiants temporaires du task role. Ne jamais placer de clé d’accès AWS dans la définition de tâche.
Les endpoints OTLP CloudWatch acceptent HTTP, pas gRPC. Les logs vont vers https://logs.eu-west-1.amazonaws.com/v1/logs, les métriques vers https://monitoring.eu-west-1.amazonaws.com/v1/metrics, les traces vers https://xray.eu-west-1.amazonaws.com/v1/traces. Un collecteur autogéré doit signer chaque exporter en SigV4 ; les logs demandent aussi les en-têtes de groupe et flux de logs. Les métriques et logs proposent également une authentification bearer, mais les traces acceptent uniquement SigV4. Pour cette charge AWS, conserver les identifiants de rôle sur tout le parcours. Exigences des endpoints OTLP.
Activer Transaction Search dans le compte et la région de réception avant d’envoyer les traces. L’intégration Dataset transfère logs et traces vers l’espace sous son propre rôle d’exécution, dans le même compte et la même région. Les métriques sont interrogées directement dans CloudWatch Metrics et ne passent pas par ce Dataset. Limiter le transfert aux groupes du lab et choisir explicitement la rétention. Envoyer la télémétrie à Omni.
Les traces seules ne suffisent pas à des vues RED complètes. Installer le plugin CloudWatch pour OpenTelemetry et configurer un exporter de métriques : le plugin produit les métriques de requêtes, erreurs et durée mais ne les exporte pas lui-même. Avec le paquet Python installé, l’auto-instrumentation charge son instrumentor de métriques de spans. Vérifier leur arrivée effective ; une série Errors absente ne signifie pas zéro erreur. Tutoriel applicatif, Plugin Python AWS, Limites de la vue service.
Contexte de release et frontières IAM
Garder service.name et service.namespace stables entre réplicas. Enregistrer service.version, le SHA du commit, le digest d’image, la révision de définition de tâche ECS et l’heure de déploiement dans un événement de release structuré. Mettre les identifiants de release sur traces et logs tout en bornant les dimensions métriques ; un identifiant par requête créerait une cardinalité inutile. Ce contrat d’événement est notre convention proposée, pas une fonction Omni automatique.
La documentation Context Graph utilise encore deployment.environment dans son exemple d’environnement, tandis que des exemples d’ingestion récents utilisent deployment.environment.name. Vérifier les attributs réellement émis par l’instrumentation installée et le regroupement appliqué par Omni ; ajouter l’ancien attribut si la vue choisie l’exige. Pour les spans SQL, vérifier le namespace de base et l’identité de destination. Un span ne contenant qu’un hostname peut rester une dépendance hostname au lieu d’être résolu vers la ressource RDS. L’absence d’une arête ne prouve pas l’absence de dépendance. Context Graph.
Séparer les responsabilités IAM :
| Rôle ou principal | Responsabilité |
|---|---|
| ECS task role | Export de télémétrie du collecteur ; appels AWS applicatifs limités si nécessaires. Partagé par les conteneurs de cette tâche. |
| ECS execution role | Téléchargement d’image, livraison awslogs et accès Secrets Manager limité pour l’injection ; droits KMS si nécessaires. |
CloudWatchOmniOperatorRole |
Accès à l’espace et configuration des intégrations. |
CloudWatchOmniDatasetIntegrationExecutionRole |
Transfert des logs et traces CloudWatch vers le Dataset. |
| Rôle de compte principal DevOps Agent | Lecture des ressources et de la télémétrie autorisées pour les investigations. |
| Rôle humain de déploiement | Création des révisions, déploiement, rollback et suppression des ressources du lab. |
Task role et execution role sont distincts dans ECS ; l’injection d’un secret ne justifie pas un accès administrateur pour le collecteur. Task role ECS, Execution role.
La configuration Omni crée ses rôles de service et demande des droits d’administration pour le setup. Les politiques d’utilisation d’espace n’autorisent ni la création du domaine ou de l’espace, ni l’ingestion de télémétrie. Avec IAM Identity Center, l’instance et le domaine Omni doivent partager une région, éventuellement via réplication. Un accès IAM depuis la console est aussi documenté. Configuration mono-compte, Politiques IAM Omni.
Quand une investigation démarre réellement
L’investigation native Omni demande un Agent Space AWS DevOps Agent relié, dans le compte depuis lequel on accède à Omni. Un administrateur attache AIDevOpsAgentFullAccess à CloudWatchOmniOperatorRole, sélectionne la région de l’Agent Space et le connecte. Le POC conserve les deux espaces en Irlande par simplicité ; la documentation d’intégration n’impose pas des régions identiques. Si Omni utilise Identity Center, configurer un mode de connexion correspondant pour l’Agent Space.
Une personne peut demander une investigation dans un fil, saisir /investigation new <description of issue> ou choisir Investigate sur une alerte Omni déclenchée. Une alerte Omni ne démarre jamais d’investigation automatiquement. La délégation automatique d’une question de recherche de cause suit la demande de l’utilisateur. Intégration des investigations Omni.
Les alertes Omni sont distinctes des alarmes CloudWatch existantes. DevOps Agent permet séparément des démarrages automatiques depuis des intégrations d’alertes ou webhooks configurés ; c’est une autre intégration à préparer et tester, hors de ce POC. Alertes Omni, Opérations DevOps Agent.
Les investigations DevOps Agent sont disponibles dans ses régions prises en charge, dont l’Irlande. Son Agent Space peut enquêter sur des ressources de plusieurs régions et comptes secondaires autorisés. La revue de préparation et les tests de release restent en preview uniquement en us-east-1 dans la table régionale vérifiée ; ne pas les supposer activés par cette intégration en Irlande. Régions DevOps Agent.
Les rôles d’accès aux ressources de l’Agent Space définissent son périmètre ; relier Omni n’ouvre pas tous les comptes AWS. Commencer par les droits de lecture de la télémétrie et des ressources du lab. Les outils natifs d’investigation ne modifient pas l’infrastructure ; le rollback reste une action humaine de déploiement dans cette expérience. Une intégration GitHub optionnelle demande un enregistrement au niveau du compte, puis la connexion des dépôts choisis. Sécurité DevOps Agent, Connexion GitHub.
Région de stockage et région d’inférence sont deux sujets distincts. L’espace Omni en Irlande conserve ses données en Irlande, mais ses requêtes IA peuvent être traitées dans les régions d’inférence UE documentées. DevOps Agent possède ses propres règles géographiques. Expurger les données sensibles des logs avant export et vérifier ces règles avant d’utiliser des données de production. Inférence inter-région Omni.
Une expérience contrôlée, pas un récit de succès
L’API proposée expose /probe et exécute une requête PostgreSQL paramétrée. En révision A, le délai configuré est zéro ; B change seulement INJECT_DB_SLEEP_MS à 250 et son libellé de release. Le handler doit refuser toute injection non nulle hors staging ; l’API compagnon le vérifie aussi au démarrage.
# Dans le handler /probe instrumenté, avec un curseur PostgreSQL.
delay_ms = int(os.environ.get("INJECT_DB_SLEEP_MS", "0"))
if delay_ms not in (0, 250):
    raise RuntimeError("Unsupported lab delay")
if delay_ms and os.environ.get("DEPLOYMENT_ENVIRONMENT") != "staging":
    raise RuntimeError("Fault injection requires staging")
cursor.execute("SELECT 1 AS ok, pg_sleep(%s)", (delay_ms / 1000,))
Cela introduit volontairement une attente en base ; cela ne reproduit pas toutes les pannes de déploiement. AWS documente Timeout:PgSleep pour RDS PostgreSQL. Le CPU n’a pas à augmenter. Attente RDS PgSleep.
Exécuter les phases dans l’ordre, avec horodatages UTC et captures de configuration :
- Baseline. Déployer A avec digest d’image, taille de tâche, nombre de réplicas et configuration de base fixes. Vérifier les targets ALB, l’export, un span serveur et son span SQL enfant. Échauffer deux minutes puis lancer dix minutes à cinq requêtes par seconde. Enregistrer débit réellement obtenu, échecs, percentiles de latence, durée SQL, CPU/mémoire ECS et connexions RDS. Arrêter si la baseline est instable ou si le générateur perd des requêtes.
- Régression contrôlée. Enregistrer B avec la même image et les mêmes ressources, en modifiant uniquement délai et libellé de release. Attendre la stabilisation ECS et le drainage des tâches A avant comparaison. Rejouer la même charge. Limiter le test au staging ; arrêter sur erreurs persistantes ou pression inattendue des ressources.
- Investigation. Sélectionner la fenêtre du déploiement dans Omni. Comparer traces A/B et logs de release. Si l’agent est relié, démarrer manuellement : préciser service, compte, région, heure de release et symptôme. Demander de distinguer corrélation de déploiement et preuve causale, puis de proposer d’autres explications. Sans agent relié, effectuer la même comparaison manuellement.
- Validation de la cause. Vérifier que le temps supplémentaire se trouve dans le span client PostgreSQL. Pendant la charge, un DBA utilise un accès VPC approuvé et ses droits PostgreSQL pour rechercher
PgSleepdanspg_stat_activity. Avec Database Insights activé, examiner l’attente correspondante. Tester saturation des connexions et CPU des tâches comme explications concurrentes. Une télémétrie manquante invalide l’expérience ; elle ne confirme pas le diagnostic. - Rollback. Une personne redéploie l’ARN complet de la définition de tâche A, en restaurant environnement, références de secrets et métadonnées de release. Attendre la stabilisation, rejouer la charge et vérifier si durée SQL et latence reviennent vers leur plage de référence. Consigner le résultat, y compris un désaccord avec l’hypothèse de l’agent.
- Nettoyage. Arrêter la charge et supprimer ECS, ALB, RDS, NAT, ECR et secrets dédiés via la stack d’infrastructure du lab. Décider explicitement de conserver ou non un snapshot RDS. Retirer alertes, groupes de logs, transfert Dataset et intégrations d’agent dédiés si le lab en est propriétaire ; respecter la rétention et les ressources partagées. Vérifier la fin des suppressions et les ressources facturables restantes.
La visibilité Database Insights demande sa propre configuration et ses droits ; l’accès IAM à la télémétrie n’accorde ni connexion PostgreSQL ni exécution SQL. Le parcours de validation du DBA est distinct du rôle AWS en lecture de l’agent. Accès Database Insights.
L’hypothèse est validée seulement si release modifiée, appel SQL plus lent, attente en base et récupération après restauration de A concordent. Sinon, examiner ce que montre réellement l’expérience. Échantillonnage, fenêtre mélangeant les révisions, carte de dépendances incomplète ou générateur de charge limitant peuvent chacun invalider la comparaison.
Lab : déployer l’infrastructure de staging
À réaliser dans un compte AWS de test en eu-west-1, avec des données synthétiques. Le résultat attendu est une expérience reproductible et un dossier de preuves ; ce lab n’a pas été déployé ni mesuré pour cet article.
- Construire. Déployer le VPC sur deux zones, l’ALB, l’API Fargate et PostgreSQL RDS privés selon le schéma. Limiter les security groups, vérifier TLS et utiliser un secret dédié. Le HTTPS public exige votre propre domaine et un certificat ACM ; sinon, choisir un ALB interne avec un générateur privé.
- Observer. Instrumenter l’API, ajouter le sidecar et ses rôles IAM, puis relier les données à l’espace Omni. Vérifier la release, les logs et le span PostgreSQL d’une requête avant l’injection.
- Comparer. Mesurer une baseline, injecter pg_sleep(0.25) uniquement en staging, rejouer la même charge et, si DevOps Agent est relié et configuré, lancer /investigation manuellement. Sinon, comparer les signaux soi-même. Valider la cause, restaurer la task definition de baseline avec ses variables, secrets/configuration et son digest figé, puis retester.
- Rendre et nettoyer. Livrer l’IaC, les digests, le draw.io adapté et des preuves expurgées des trois phases. Supprimer les ressources jetables et contrôler snapshots, logs et NAT/EIP restants. Consulter les tarifs AWS avant de créer les ressources facturables.
Sources officielles et vérification
Les sources ci-dessus ont été consultées le 6 octobre 2026. Commencer par les concepts Omni, l’ingestion applicative, les endpoints OTLP, les investigations Omni, les régions DevOps Agent et la référence RDS PgSleep. Vérifier de nouveau disponibilité, politiques IAM, versions d’instrumentation et tarification avant de réaliser le lab.
Cloud, DevOps et agents IA. Le journal Kloud.
Retour au journal